
BLOG
Sikai Blog
Recruiting-AI engineering, product and industry insight from the Xiaoxi data-science team.
 Data engineering
同一个候选人的五份简历,系统到底该不该自动合并?
从阻塞、字段证据、概率匹配、聚类风险和人工复核出发,设计不会轻易串人的候选人实体消歧流程。
Read →
 Resume parsing
简历解析准确率怎么测,才不会被一个数字误导?
从信息抽取指标、记录对齐、错误分类、置信度校准与线上漂移出发,建立一套可复现的简历解析评估体系,并给出采购与验收问题清单。
Read →
 Industry insight
招聘智能体如何落地:从“会聊天”到“能完成受控流程”
结合 ReAct、Toolformer 与 NIST 智能体安全研究,拆解招聘 Agent 的模型、工具、状态、权限、审批、幂等和提示注入防护。
Read →
 Matching
从岗位名称到技能证据:人岗匹配应该如何升级
结合 OECD skills-first 研究、ESCO 职业技能分类与跨语言映射实践,拆解技能型匹配如何建立技能概念、经历证据、岗位约束和可解释排序。
Read →
 Resume parsing
从 OCR 到多模态理解:复杂简历解析为什么更需要“看懂版面”
结合 LayoutLMv3、LayoutXLM、XYLayoutLM、Donut 与 UDOP 研究,解释文本、坐标、视觉和阅读顺序如何共同决定简历结构,以及 OCR 与 OCR-free 路线如何选择。
Read →
 Industry insight
招聘 AI 不只要准确,还要可解释、可复核、可退出
结合《个人信息保护法》、个人信息保护合规审计指引、欧盟 AI Act 与 NIST AI RMF,拆解招聘 AI 从数据使用到自动化决策的产品与工程控制。
Read →
 Knowledge graph
技能词表一升级,为什么历史匹配结果全变了?
从稳定标识、版本快照、映射类型、双轨迁移和回归评测出发,说明招聘技能知识库如何在持续更新中保持结果可解释、可重算。
Read →
 AI governance
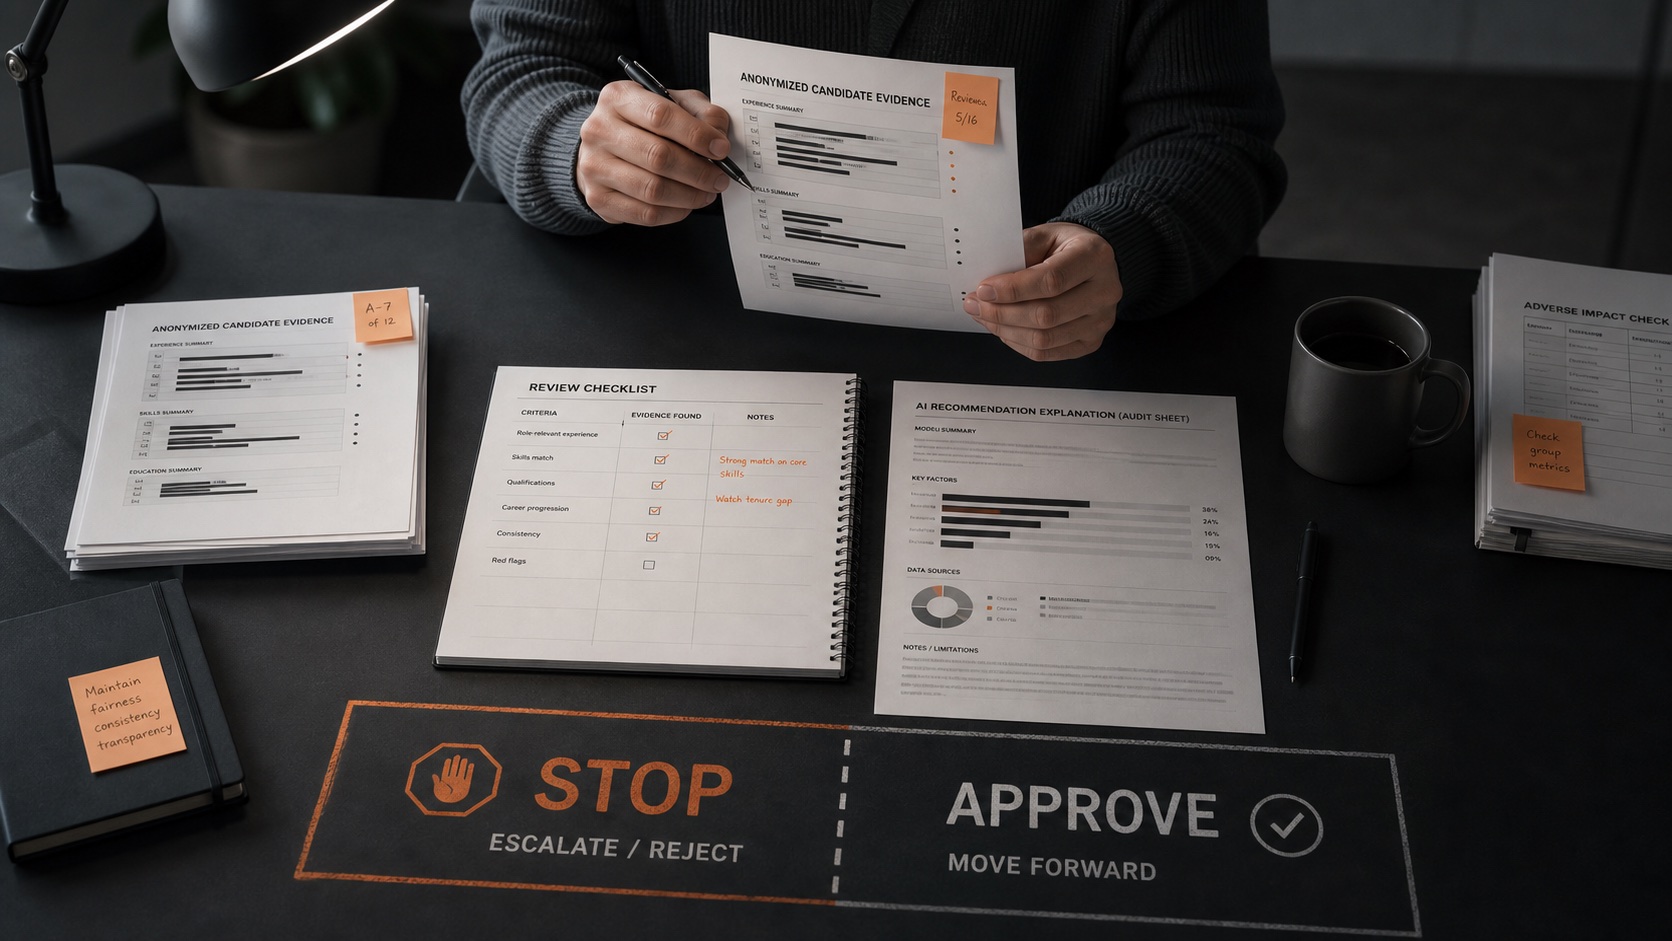
招聘 AI 有人工复核,为什么仍然可能失控?
解释橡皮图章式复核为何无效,并从权限、证据、时间、独立判断和申诉闭环设计真正有意义的人类监督。
Read →
 Knowledge graph
RAG 如何让招聘 AI 的回答更有依据?
深入拆解招聘 RAG 的知识组织、权限过滤、混合检索、重排、引用与评估,并解释为什么“向量库 + 大模型”不足以支撑真实人才数据场景。
Read →